
تفتح تطبيق الموسيقى بعد أسابيع من الاستخدام فتجد أن الاقتراحات صارت أقرب إلى ذوقك مما كانت. لم يُعد أحد تصميم التطبيق، ولم يصلك تحديث جديد. ما حدث أن النظام تكيّف مع سلوكك. هذا هو جوهر الذكاء الاصطناعي التكيفي (Adaptive AI): أنظمة لا تتوقف عن التعلم عند لحظة النشر، بل تعدّل سلوكها وفق ما ترصده من بيانات وتغذية راجعة أثناء التشغيل.
غير أن الفكرة أكثر التباساً مما تبدو. يظن كثيرون أن كل أداة تتذكر اسمك تتعلم منك، وهذا في الغالب غير صحيح. سنفصل في هذا الدليل بين ما يتعلم فعلاً وما يكتفي بالتذكر، ونشرح المخاطر التي تغيب عن العروض التسويقية، ثم نصل إلى سؤال عملي: هل يستحق مشروعك هذا التعقيد أصلاً؟
إجابات سريعة قبل أن تتعمق
ما الفرق بين الذكاء الاصطناعي التكيفي والتعلم الآلي التقليدي؟
يتعلم النموذج التقليدي مرة واحدة ثم يُنشر ثابتاً، أما النظام التكيفي فيواصل تحديث معاييره أثناء التشغيل استناداً إلى بيانات جديدة. التكيف إذن ليس بديلاً عن التعلم الآلي، بل طريقة في نشره وإدارته بعد الإطلاق.
هل ChatGPT يتعلم من محادثاتي فعلاً؟
ليس بالمعنى الذي يتوقعه معظم الناس. ميزة الذاكرة في أدوات الدردشة تخزّن معلومات عنك وتعيدها إلى السياق عند الحاجة، ولا تعني أن أوزان النموذج تتغير بعد كل محادثة. أما استخدام محادثاتك في تحسين نماذج مستقبلية فمسار منفصل تحكمه سياسة الجهة المزوّدة وإعداداتك.
ما أكبر خطر في الأنظمة التي تتعلم أثناء الاستخدام؟
أكبر خطرين هما النسيان الكارثي (Catastrophic Forgetting) الذي يمحو معرفة سابقة، وحلقات التغذية الراجعة (Feedback Loops) التي تضخّم أخطاء النظام لأنه يتعلم من نتائج قراراته هو. كلاهما يحتاج إلى مراقبة مستمرة، وليس إلى إعداد يُنجز مرة واحدة.
هل يحتاج مشروعك إلى نظام تكيفي؟
في معظم الحالات لا. إعادة تدريب دورية مجدولة مع مراقبة جيدة تكفي، وهي أرخص وأسهل في التدقيق. يستحق التكيف اللحظي الاستثمار حين تتغير البيانات بسرعة وتكون كلفة الخطأ المتأخر عالية، كما في كشف الاحتيال.
ما هو الذكاء الاصطناعي التكيفي؟
التعريف المختصر للذكاء الاصطناعي التكيفي
الذكاء الاصطناعي التكيفي هو نوع من الأنظمة الذكية يعدّل سلوكه أو معاييره بعد النشر استناداً إلى البيانات والتغذية الراجعة الجديدة، دون الحاجة إلى إعادة بناء النموذج من الصفر.
الفكرة ليست جديدة في جذورها، فأبحاث التعلم المستمر (Continual Learning) والتعلم مدى الحياة (Lifelong Learning) قديمة في الأوساط الأكاديمية. الجديد أن شركة الأبحاث Gartner أدرجت المفهوم ضمن اتجاهاتها التقنية الاستراتيجية لعام 2023، فخرج من الأوراق البحثية إلى طاولات الإدارة. ومنذ ذلك الحين لم يعد السؤال «هل نستطيع؟» بل «كيف نفعلها دون أن نفقد السيطرة؟».
الفرق بينه وبين الأنظمة الثابتة
يقع التكيف داخل مظلة التعلم الآلي، لا خارجها. وإن لم تكن الحدود بين المفهومين واضحة عندك، فمراجعة الفرق بين الذكاء الاصطناعي والتعلم الآلي ستمنحك الأساس الذي يقوم عليه ما سيأتي. الفرق الحقيقي ليس في نوع الخوارزمية، بل فيما يحدث بعد الإطلاق: النموذج الثابت يُجمَّد ويُراقَب من بعيد، والنظام التكيفي يبقى في حالة تعلم.
| الجانب | النموذج الثابت | النظام التكيفي |
|---|---|---|
| التعلم | مرة واحدة قبل النشر | مستمر أثناء التشغيل |
| التحديث | إصدار جديد بقرار بشري | تلقائي أو شبه تلقائي ضمن حدود مرسومة |
| التكلفة | أقل تشغيلياً | أعلى بسبب المراقبة والتقييم المتكرر |
| أبرز المخاطر | تدهور الدقة مع مرور الزمن | النسيان الكارثي وتسميم البيانات |
| الأنسب لـ | بيئات مستقرة وقرارات منخفضة المخاطر | بيئات سريعة التغير مثل الاحتيال والتوصية |
لماذا لا تصمد النماذج الثابتة أمام عالم يتغير؟
تتدهور دقة النماذج الثابتة مع الزمن لأن البيانات الواقعية تتغير، وتُعرف هذه الظاهرة تقنياً بالانحراف (Drift). يُدرَّب النموذج على لقطة من الماضي ثم يُطلب منه التنبؤ بالمستقبل، وكلما ابتعد المستقبل عن اللقطة تراجعت الدقة بصمت، دون رسالة خطأ واحدة. هذا التراجع الصامت هو ما حوّل فكرة التكيف من ترف بحثي إلى حاجة هندسية.
انحراف البيانات وانحراف المفهوم
يحدث انحراف البيانات (Data Drift) حين يتغير شكل المدخلات نفسها، بينما يحدث انحراف المفهوم (Concept Drift) حين تتغير العلاقة بين المدخلات والنتيجة الصحيحة. الخلط بينهما يقود إلى علاج خاطئ: الأول قد يُعالَج بتحديث بيانات التدريب، أما الثاني فيعني أن القاعدة التي تعلمها النموذج لم تعد صالحة أصلاً. ولمن أراد خلفية أكاديمية أوسع، تقدّم ويكيبيديا شرحاً جيداً عن انحراف المفهوم.
| نوع الانحراف | ما الذي يتغير؟ | مثال واقعي |
|---|---|---|
| انحراف البيانات | توزيع المدخلات | نموذج لفهم النصوص العربية يبدأ باستقبال رسائل بلهجات ومصطلحات لم يرها في التدريب |
| انحراف المفهوم | العلاقة بين المدخل والنتيجة | سلوك شرائي كان يُعد آمناً صار مؤشراً على احتيال بعد ابتكار أسلوب جديد |
مثال يبسّط الفكرة: كشف الاحتيال
تخيّل نظاماً لكشف الاحتيال في المدفوعات الإلكترونية دُرّب على أنماط السنة الماضية. المحتالون لا يقرأون تقارير التدريب، بل يغيّرون أساليبهم أسبوعاً بعد أسبوع. بعد ثلاثة أشهر ستجد النظام يوقف عملاء شرعيين لأن سلوكهم صار غريباً عن ماضيه، ويمرّر عمليات مشبوهة لأنها تشبه «المعاملة الآمنة» كما عرفها. هنا يصبح تحديث النموذج مسألة أيام أو أسابيع، لا سنوات.
كيف تتعلم الأنظمة الذكية أثناء الاستخدام؟
التعلم المستمر لا يحدث بطريقة واحدة. يمكن تقسيمه إلى ثلاثة مستويات تختلف في العمق والكلفة والخطورة، وفهم هذا التقسيم يحميك من تصديق أي ادعاء تسويقي بلا تدقيق.
المستوى الأول: التكيف عبر السياق والاسترجاع
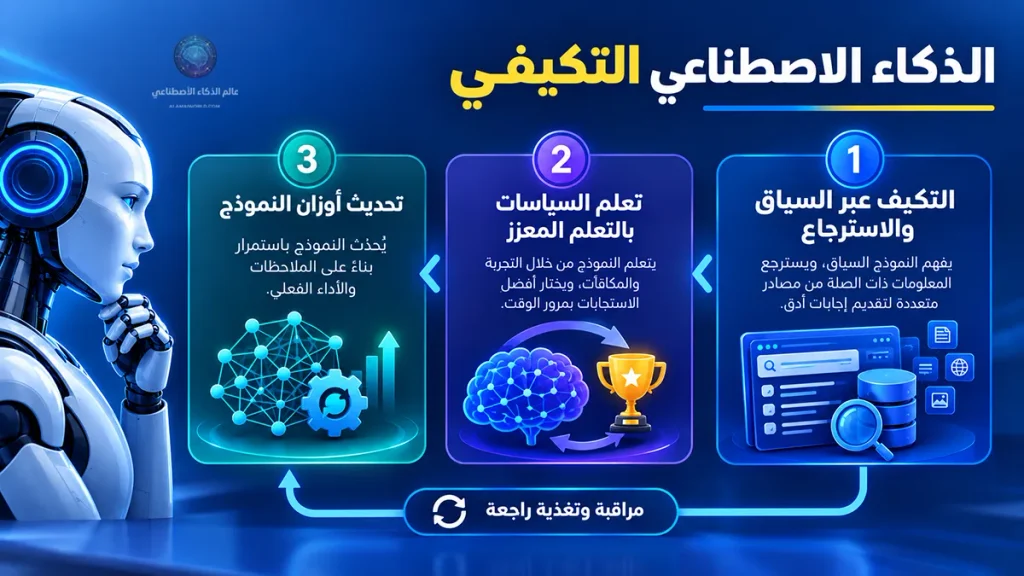
لا تتغير الأوزان هنا أبداً. يتلقى النظام معلومات جديدة داخل المطالبة، وهو ما يسمى التعلم داخل السياق (In-context Learning)، أو يسترجعها من قاعدة معرفة عبر التوليد المعزز بالاسترجاع (RAG)، فيبدو وكأنه تعلّم. هذا المستوى الأسرع والأرخص والأسهل تراجعاً، ولذلك تعتمد عليه أغلب أدوات الدردشة التي تعلن عن التخصيص (Personalization).
المستوى الثاني: التعلم المعزز وقطاع الطرق متعددو الأذرع
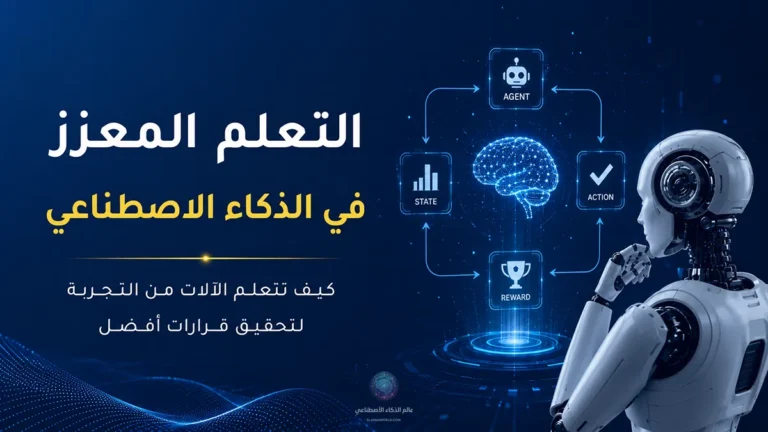
يتعلم النظام هنا سياسة اختيار لا معرفة جديدة. في التعلم المعزز (Reinforcement Learning) تكافئ النتائج الجيدة القرار الذي أنتجها، وفي خوارزميات قطاع الطرق متعددي الأذرع (Multi-armed Bandits) يوازن النظام بين تجربة خيار جديد واستغلال أفضل خيار عرفه حتى الآن. عندما يختبر متجر إلكتروني عدة عناوين أو ترتيبات للمنتجات ثم يميل تدريجياً إلى الأنجح، فهذا هو المثال المألوف.
ولا تخلط بين هذا وبين التعلم المعزز من التغذية الراجعة البشرية (RLHF)، فهو يجري غالباً أثناء تدريب النموذج قبل إطلاقه، لا أثناء استخدامك له.
المستوى الثالث: التعلم عبر الإنترنت وتحديث الأوزان
هذا هو المستوى الأعمق. في التعلم عبر الإنترنت (Online Learning) تُحدَّث أوزان النموذج تدريجياً مع وصول كل دفعة صغيرة من البيانات، بدل إعادة التدريب على مجموعة ضخمة. قوته أنه يلحق بالتغير سريعاً، وضعفه أنه الأخطر، لأن أي خلل في البيانات يدخل إلى النموذج نفسه مباشرة. لذلك لا يُستخدم إلا حيث تبرر السرعة المخاطرة.
دورة التغذية الراجعة خطوة بخطوة
مهما اختلف المستوى، تتكرر الدورة نفسها تقريباً في أي نظام ناضج:
- جمع البيانات الجديدة ومراقبة أداء النظام الحالي.
- اكتشاف الانحراف عبر مقارنة التوزيعات والنتائج.
- تقييم الأداء على عينة موثوقة موسومة بعناية.
- تحديث النموذج أو سياسته.
- اختبار النسخة الجديدة في بيئة معزولة قبل أن تمسّ المستخدمين.
- النشر مع الإبقاء على طريق للتراجع الفوري.
الخطوة الخامسة هي التي تُهمَل غالباً في العروض التجريبية، وهي التي تفصل بين نظام يعمل في العرض ونظام يعمل في الإنتاج.
هل ChatGPT وأدوات الدردشة ذكاء اصطناعي تكيفي؟
ليس بالمعنى التقني الدقيق. تتصرف نماذج الدردشة الكبرى كنماذج ثابتة خلال المحادثة، وتتحسن عبر إصدارات جديدة يقررها مطوّروها، لا عبر تعلم لحظي منك أنت.
الفرق بين «الذاكرة» والتعلم الفعلي
ميزة «الذاكرة» في أدوات الدردشة تخزّن معلومات وتسترجعها في السياق، ولا تعني بالضرورة تحديث أوزان النموذج. الفرق يشبه الفرق بين موظف يدوّن ملاحظاتك في دفتر ويعود إليها، وموظف يغيّر طريقة تفكيره ذاتها بعد كل لقاء. الأول مفيد ومأمون، والثاني أقوى وأخطر.
ويمكنك أن تتحقق بنفسك في عشر دقائق. اطلب من الأداة مهمة كتابية محددة وسجّل النتيجة، ثم زوّدها بتفضيلاتك بوضوح وأعد الطلب نفسه في محادثة جديدة، ثم عطّل الذاكرة إن أمكن وكرر التجربة. إن تحسنت النتيجة فقط عندما تكون معلوماتك حاضرة في السياق، فأنت أمام استرجاع لا تعلم. دوّن ما لاحظته بدقة، فنتائجك الشخصية أثمن من أي شرح نظري.
مقارنة الضبط الدقيق وRAG والتعلم المستمر
تختلط هذه المفاهيم الثلاثة في أذهان أغلب القراء، وهي مختلفة في جوهرها. الضبط الدقيق (Fine-tuning) يعيد تدريب نموذج جاهز على بيانات محددة، وقد يتم بتقنيات خفيفة مثل LoRA تقلل الكلفة كثيراً.
| الجانب | الضبط الدقيق (Fine-tuning) | RAG | التعلم المستمر |
|---|---|---|---|
| ما الذي يتغير؟ | أوزان النموذج، على دفعات | المصدر المسترجع فقط، والأوزان ثابتة | الأوزان تُحدَّث تدريجياً |
| وتيرة التحديث | مجدولة ومتقطعة | فورية بتحديث قاعدة المعرفة | متواصلة |
| الأنسب لـ | تخصيص أسلوب أو مجال | معلومات متغيرة وموثقة | بيئات سريعة الانحراف |
| أبرز خطر | فقدان قدرات عامة | ضعف جودة المصادر | النسيان وتسميم البيانات |
كيف تكشف ادعاء التكيف الزائف؟
حين تقرأ عبارة «يتعلم منك» في وصف أداة، اسأل عن الآلية قبل أن تصدّق. هذه علامات تدل على أن النظام لا يتكيف فعلاً:
- لا يستطيع المزوّد أن يخبرك ما الذي يتغير بالضبط: الأوزان أم السياق أم الإعدادات.
- يختفي «التعلم» عند فتح محادثة جديدة أو تعطيل الذاكرة.
- لا يوجد أي حديث عن المراقبة أو التراجع أو إصدارات النموذج.
- يتحدث الوصف عن النتائج المبهرة دون أي ذكر للقيود.
أين نرى هذه الأنظمة تعمل فعلاً؟
التوصية والتخصيص
تعتمد منصات مثل Netflix وSpotify على أنظمة التوصية (Recommender Systems) التي تتأثر بمشاهداتك واستماعك وتعيد ترتيب الاقتراحات باستمرار. هذا أوسع تطبيق تجاري للتكيف وأكثره ألفة، وهو أيضاً أرض خصبة لأخطر مشكلاته، كما سنرى بعد قليل.
الأمن السيبراني وكشف الاحتيال
هنا يصبح التكيف شبه إلزامي لأن الخصم نفسه يتكيف. يحتاج النظام إلى مصدر بيانات حي وإلى مخزن ميزات (Feature Store) يوفر المدخلات نفسها في التدريب والتشغيل، وإلا نشأ فرق خفي بين ما تعلمه وما يراه.
التعليم التكيفي
تعدّل منصات تعلم اللغات مثل Duolingo مستوى الصعوبة وتسلسل الدروس وفق أدائك، فيتقدم المتعلم السريع ويُعاد شرح ما تعثر فيه البطيء. المكسب واضح، لكن المعيار الحقيقي هو أن يتحسن التعلم فعلاً لا أن يزيد التفاعل فقط.
الأنظمة الذاتية والروبوتات
تتكيف السيارات الذاتية القيادة والروبوتات مع الظروف لحظياً في الإدراك واتخاذ القرار. أما تحديث النماذج نفسها فيمر عادة عبر مراحل اختبار صارمة، لأن الخطأ هنا قد يكلف حياة لا مجرد خسارة نقر.
مخاطر لا تظهر في العروض التسويقية
النسيان الكارثي
حين يتعلم النموذج شيئاً جديداً قد يمحو ما تعلمه قبله، وهذه هي مشكلة النسيان الكارثي. تخيّل نموذجاً تكيّف بإتقان مع أسلوب عملاء هذا الشهر، ثم تجده عاجزاً عن التعامل مع حالات كان يحلها بسهولة الشهر الماضي. علاجه يكون بإبقاء عينة من البيانات القديمة ضمن التدريب، واختبار كل تحديث على مجموعة قياس ثابتة لا تتغير.
حلقات التغذية الراجعة المنحرفة
يتعلم النظام من نتائج قراراته هو، فيعزز ما فعله سابقاً. نظام توصية يعرض لك نوعاً واحداً من المحتوى لأنك نقرت عليه، ثم يتعلم أنك تحبه أكثر، فيضيق أفقك تدريجياً وتُقرأ هذه الضيقة كأنها «ذوق» أصيل. الخطر أن مؤشرات الأداء تبدو ممتازة طوال الوقت، بينما الجودة الفعلية تتراجع.
تسميم البيانات والتلاعب
النظام الذي يتعلم من مدخلات المستخدمين قابل للتلاعب بهم. المثال الأشهر هو روبوت الدردشة Tay من مايكروسوفت، الذي أُطلق على تويتر عام 2016 وسُحب خلال يوم واحد تقريباً بعد أن غمره مستخدمون بمدخلات مسيئة متعمدة فبدأ يكررها. الدرس لا يخص الروبوت وحده: كل نظام يتعلم من الجمهور يحتاج إلى مرشحات وحدود على ما يُسمح له بتعلمه.
لماذا يصعب التدقيق والتقييم؟
حين يتغير النموذج باستمرار، يفقد أي تدقيق صلاحيته سريعاً: ما فُحص اليوم ليس ما سيعمل غداً. لذلك تحتاج هذه الأنظمة إلى إصدارات موثقة وسجلات تغيير، لا إلى تقرير فحص واحد يُعلَّق على الجدار.
الجانب العربي: لهجات ومصطلحات تتحرك
تضيف العربية طبقة خاصة من الصعوبة. اللهجات تختلف من بلد إلى آخر، والمصطلحات التقنية والشبابية تتبدل بسرعة، وبيانات التقييم العربية الموثقة أقل بكثير من نظيرتها الإنجليزية. النتيجة أن الانحراف يقع أسرع وأصعب اكتشافاً، لأنك لا تملك معياراً جيداً تقيس عليه ما إذا كان النظام تحسّن أم انحرف.
من يملك ما يتعلمه النظام؟ الخصوصية والملكية
التعلم المركزي مقابل التعلم الاتحادي والتعلم على الجهاز
في التعلم المركزي تُجمع بيانات المستخدمين في خوادم الشركة ثم يُدرَّب عليها النموذج. أما التعلم الاتحادي (Federated Learning) فيُبقي البيانات على أجهزة أصحابها، ولا يُرسل إلى الخادم إلا تحديثات النموذج المحسوبة محلياً. والتعلم على الجهاز (On-device Learning) يذهب أبعد، فيبقى التعلم كله داخل الهاتف. كلما اقتربت المعالجة من صاحب البيانات ازدادت الخصوصية، وازدادت معها صعوبة التنسيق والتقييم.
الأطر القانونية: GDPR وPDPL وقانون الذكاء الاصطناعي الأوروبي
لا تُعامَل البيانات التي يتعلم منها النظام معاملة البيانات المخزنة فقط. يفرض اللائحة الأوروبية لحماية البيانات (GDPR) ونظام حماية البيانات الشخصية السعودي (PDPL) ومنظومات مماثلة في دول عربية أخرى التزامات تتعلق بالموافقة والغرض من الاستخدام وحقوق أصحاب البيانات، كما وضع قانون الذكاء الاصطناعي الأوروبي (EU AI Act) متطلبات إضافية بحسب مستوى خطورة النظام. تختلف التفاصيل باختلاف البلد والقطاع، فاستشر مختصاً قانونياً قبل بناء أي نظام يتعلم من بيانات شخصية.
ونقطة يغفلها كثيرون: عقود الاستخدام هي التي تحدد ما إذا كان من حق المزوّد الاستفادة من بياناتك في تحسين نموذجه، وما إذا كانت التحسينات الناتجة تُنسب إليه أم إليك. اقرأ هذه البنود قبل التوقيع لا بعده.
كيف تبني نظاماً تكيفياً دون أن تفقد السيطرة؟
مراقبة النماذج والإنذار المبكر
مراقبة النماذج (Model Monitoring) هي خط الدفاع الأول، وهي جزء من ممارسات MLOps الأوسع لإدارة دورة حياة النماذج. راقب توزيع المدخلات ودقة المخرجات ومؤشرات تخصك أنت لا المؤشرات الجاهزة فقط، وحدّد عتبات تنبيه تُشعرك بالانحراف قبل أن يشتكي المستخدمون.
Shadow Deployment والإصدارات والتراجع
قبل أن تسمح لنسخة محدَّثة بالتأثير على المستخدمين، شغّلها بصمت في الخلفية بنمط النشر الظلي (Shadow Deployment) وقارن قراراتها بقرارات النسخة الحالية. احتفظ بإصدارات مرقمة لكل نموذج، وحافظ على قدرة التراجع إلى الإصدار السابق بضغطة واحدة. ما لا يمكن التراجع عنه لا يجوز نشره.
الإشراف البشري (Human-in-the-loop)
اجعل الإنسان جزءاً من الحلقة عند القرارات الحساسة: تحديثات كبيرة تحتاج موافقة، وحالات غير مؤكدة تُحال إلى مراجع بشري، وعينات عشوائية تُراجَع يدوياً. الأتمتة الكاملة ليست هدفاً بحد ذاتها، بل ما يُتيحه الإشراف الذكي من سرعة دون فقدان للمساءلة.
اختيار النموذج الأساسي
تتفاوت النماذج في مقدار التحكم الذي تمنحك إياه. السيطرة على التحديث والضبط الدقيق والتشغيل على الجهاز أسهل عادةً مع النماذج المفتوحة منها مع المغلقة، وتفاصيل هذا التفاضل مشروحة في دليل اختيار النماذج مفتوحة المصدر في الذكاء الاصطناعي 2026. اقرأه قبل أن تلتزم بأي منصة، فقرار النموذج الأساسي يحدد سقف ما يمكنك فعله لاحقاً.
التكلفة الحقيقية… ومتى لا تحتاج هذا كله؟
عناصر التكلفة الخفية
لا تنحصر الكلفة في الحوسبة. تشمل بنية المراقبة المستمرة، والتقييم المتكرر، وجودة وسم البيانات التي يعتمد عليها التحديث، والكمون (Latency) الناتج عن الفحوص الإضافية، وفريقاً يفهم كل ذلك ويتابعه. كثير من المشاريع تكتشف أن ثمن الأمان في التكيف يفوق ثمن التكيف نفسه.
تكيف لحظي أم إعادة تدريب دورية؟
اسأل نفسك ثلاثة أسئلة. هل تتغير بياناتك بسرعة تُفقد النموذج صلاحيته خلال أسابيع؟ هل الخطأ المتأخر مكلف بما يكفي لتبرير رقابة مستمرة؟ هل لديك فريق قادر على مراقبة النظام يومياً؟ إن كانت إجابتك «لا» على أي منها، فإعادة تدريب دورية مجدولة أنسب لك. وإن كانت «نعم» على الثلاثة، فأنت مرشح فعلي لنظام يتعلم أثناء التشغيل، بالبدء من المستوى الأول ثم الصعود تدريجياً.
إلى أين تتجه هذه الأنظمة؟
الوكلاء الذكية (Agentic AI) والتعلم المستمر
مع صعود الوكلاء الذكية (Agentic AI) التي تنفذ مهاماً متعددة الخطوات بدل الإجابة عن سؤال واحد، تزداد قيمة القدرة على التعلم من نتائج المهام السابقة. لكن كل وكيل يتعلم ذاتياً يضاعف الحاجة إلى الحدود والتدقيق. الاتجاه العام واضح: أنظمة أقدر على التغير، ومعها مسؤولية أكبر على من يشغّلها. والفريق الذي يبني المراقبة والتراجع والإشراف اليوم سيكون الأقدر على الاستفادة من هذه القفزة غداً.
الأسئلة الشائعة
ما الفرق بين التعلم المستمر والضبط الدقيق؟
التعلم المستمر يحدّث النموذج تدريجياً بدفعات صغيرة أثناء التشغيل، أما الضبط الدقيق فيعيد تدريب نموذج جاهز على بيانات محددة في جولة منفصلة ثم يُنشر ثابتاً من جديد. الأول يتغير باستمرار ويحتاج رقابة لحظية، والثاني يتغير على دفعات مجدولة ويسهل اختباره قبل الإطلاق.
هل يستخدم ChatGPT بياناتي لتحسين نفسه؟
يعتمد ذلك على نوع حسابك وإعدادات التحكم في البيانات. قد تُستخدم محادثات الحسابات الفردية في تحسين النماذج ما لم تعطّل الخيار المتاح في إعدادات الخصوصية، بينما تخضع خطط الأعمال والواجهة البرمجية لسياسات مختلفة. راجع سياسة الخصوصية الحالية للخدمة قبل مشاركة أي معلومات حساسة.
هل الذكاء الاصطناعي التكيفي خطر؟
ليس خطراً بذاته، لكنه يرفع مستوى المخاطر التشغيلية إذا غاب الإشراف، لأن النظام يتغير بعد أن تفحصه. تنشأ أخطر المشكلات من النسيان الكارثي وحلقات التغذية الراجعة وتسميم البيانات، وكلها تُحتوى بالمراقبة والإصدارات وقابلية التراجع والمراجعة البشرية.
هل يمكن للشركات الصغيرة استخدامه؟
نعم، لكن بنسخة مخففة. تستطيع الشركات الصغيرة الاستفادة من المستوى الأول عبر RAG، ومن اختبارات قطاع الطرق متعددي الأذرع في المتاجر والحملات، مع إعادة تدريب دورية بسيطة للنماذج التي تملكها. تحديث الأوزان اللحظي غير مناسب لها غالباً، فكلفة مراقبته أعلى من عائده.
كيف أعرف أن أداة تدّعي أنها تتعلم من استخدامي تتكيف فعلاً؟
اسأل المزوّد عمّا يتغير بالضبط: الأوزان أم السياق أم الإعدادات. ثم اختبر الأداة بمحادثة جديدة مع تعطيل الذاكرة، فإن اختفى «التعلم» فهو استرجاع لا تعلم. وأخيراً ابحث عن ذكر واضح للمراقبة والإصدارات وإمكانية التراجع، فغيابها علامة على أن الادعاء تسويقي أكثر منه هندسياً.

مؤسس موقع عالم الذكاء الاصطناعي. أكرس وقتي لمراجعة وتبسيط أدوات وتقنيات الذكاء الاصطناعي الحديثة. وبحكم خبرتي العملية في التسويق الرقمي وإدارة الحملات الإعلانية، أركز في مقالاتي على تقديم أدلة عملية تساعدك على استغلال هذه الأدوات بذكاء لتطوير أعمالك وتحقيق نتائج حقيقية.